Từ Dữ Liệu Thô Đến Thông Tin Hữu Ích – Khóa Học Phân Tích Dữ Liệu Thực Tế

Bạn có biết rằng trong một hệ thống quản lý, có hàng nghìn bản ghi dữ liệu nhưng không biết cách kết nối chúng?
Ví dụ thực tế: Trong hệ thống PCCC, chúng ta có:
- 702 thiết bị với địa chỉ lắp đặt
- 221 cơ sở cần tọa độ địa lý
- Làm sao để tự động match và cập nhật tọa độ?
Hình ảnh: Kết quả phân tích dữ liệu hiển thị trên bản đồ với các marker cho cơ sở và thiết bị
Khóa học Phân Tích Dữ Liệu sẽ dạy bạn: Kỹ thuật chuẩn hóa dữ liệu (normalize string) Fuzzy matching để tìm các bản ghi tương tự Tự động hóa quy trình cập nhật dữ liệu Xử lý dữ liệu lớn với Python và PostgreSQL
Hệ thống Phòng Cháy Chữa Cháy (PCCC)


Trong 1 hệ thống quản lý PCCC điển hình, chúng ta có:
- 702 thiết bị đã lắp đặt nhưng địa chỉ ghi không đồng nhất
- 221 cơ sở chưa có tọa độ địa lý chính xác
- Nhu cầu: Tự động đối chiếu địa chỉ lắp đặt và cập nhật tọa độ GPS mà không phải nhập tay
Câu hỏi đặt ra:
Làm sao để bot hoặc hệ thống có thể tự match địa chỉ và cập nhật tọa độ một cách tự động?
Fin3B và tư duy xử lý dữ liệu trong thực tế
Đây chính là điểm mà các hệ thống thông minh như Fin3B trong mảng bot/trading hoặc monitoring đều phải đi qua: biến dữ liệu thô thành tín hiệu hoặc thông tin có thể hành động được.
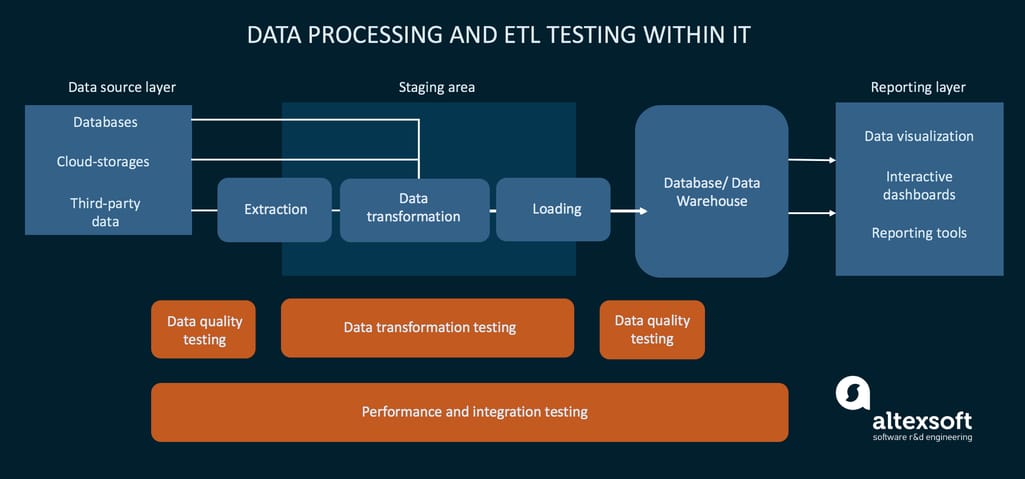
Để làm được điều đó, trader hay kỹ sư dữ liệu cần làm chủ 3 khối:
- Thu thập dữ liệu thô (Raw Data Block)
- Chuẩn hóa và phân tích (Logic/AI Block)
- Giám sát và cập nhật liên tục (Monitoring Block)
Khóa học Phân Tích Dữ Liệu sẽ dạy bạn những gì?

Trong khóa học, bạn sẽ thực hành trực tiếp các kỹ thuật quan trọng:
1. Chuẩn hóa dữ liệu
- Normalize chuỗi (loại bỏ ký tự thừa, viết hoa/viết thường, dấu câu sai lệch)
2. Fuzzy Matching
- Dùng thuật toán đo độ tương đồng chuỗi để tìm các bản ghi gần giống nhau
- Nhận diện trùng lặp dữ liệu dù không khớp 100%
3. Tự động hóa quy trình cập nhật
- Xây dựng workflow tự đối chiếu – cập nhật mà không cần thao tác thủ công
- Ứng dụng Python, n8n automation hoặc database triggers
4. Xử lý dữ liệu lớn
- Làm việc với tập dữ liệu hàng nghìn bản ghi
- Dùng Python và PostgreSQL/MySQL để xử lý, lọc và tối ưu
Đi sâu: kỹ thuật match dữ liệu địa chỉ
Bài toán "đối chiếu 702 thiết bị với 221 cơ sở" nghe có vẻ đơn giản, nhưng thực tế địa chỉ ghi trong hệ thống luôn khác nhau:
| Cơ sở trong hệ thống | Địa chỉ thiết bị ghi | Vấn đề |
|---|---|---|
| Công ty TNHH ABC | Cty TNHH ABC | Viết tắt |
| 123 Nguyễn Trãi, P.5, Q.1 | 123 Nguyễn Trãi Phường 5 Quận 1 | Dấu câu |
| Số 45 Lê Lợi | 45 Lê Lợi | Từ "Số" |
| KCN Tân Bình, Lô C3 | KCN Tan Binh Lo C3 | Mất dấu |
| Trường THCS Nguyễn Du | Trường Trung học cơ sở Nguyễn Du | Viết đầy đủ |
Không có thuật toán nào so khớp chính xác được những trường hợp này. Đó là lý do cần chuẩn hoá + fuzzy matching.
Bước 1 — Chuẩn hoá chuỗi (normalization)
import re
import unicodedata
from functools import lru_cache

TU_VIET_TAT = {
    "cty": "cong ty", "tnhh": "trach nhiem huu han",
    "cp": "co phan", "tp": "thanh pho", "q": "quan",
    "p": "phuong", "p.": "phuong", "qh": "quan huyen",
    "tt": "thi tran", "xa": "xa", "phong": "phuong",
    "kcn": "khu cong nghiep", "kcx": "khu che xuat",
    "thcs": "trung hoc co so", "thpt": "trung hoc pho thong",
    "so": "", "số": "",
}


@lru_cache(maxsize=10_000)
def chuan_hoa(dia_chi: str) -> str:
    """Chuẩn hoá địa chỉ thành dạng so sánh được."""
    if not dia_chi:
        return ""

    # 1. Chuẩn hoá Unicode (quan trọng: NFC vs NFD gây lỗi so khớp)
    s = unicodedata.normalize("NFC", str(dia_chi)).lower().strip()

    # 2. Bỏ dấu tiếng Việt
    s = "".join(
        c for c in unicodedata.normalize("NFD", s)
        if unicodedata.category(c) != "Mn"
    ).replace("đ", "d")

    # 3. Bỏ mọi dấu câu, chuẩn hoá khoảng trắng
    s = re.sub(r"[^a-z0-9\s/]", " ", s)
    s = re.sub(r"\s+", " ", s).strip()

    # 4. Mở rộng từ viết tắt (so khớp theo từ, không theo chuỗi con)
    tu = s.split()
    tu = [TU_VIET_TAT.get(t, t) for t in tu]
    return " ".join(t for t in tu if t)
Chi tiết dễ bị bỏ qua nhưng gây lỗi: unicodedata.normalize("NFC", ...). macOS lưu tên file ở dạng NFD, Windows ở dạng NFC. Hai chuỗi nhìn giống hệt nhau có thể khác nhau ở mức byte. Nếu bạn không chuẩn hoá, việc so sánh sẽ thất bại một cách khó hiểu.
Bước 2 — Fuzzy matching
from difflib import SequenceMatcher
from collections import defaultdict


def do_tuong_dong(a: str, b: str) -> float:
    """Độ tương đồng 0..1 giữa hai chuỗi đã chuẩn hoá."""
    return SequenceMatcher(None, a, b).ratio()


def token_set_ratio(a: str, b: str) -> float:
    """So khớp theo tập từ — bỏ qua thứ tự từ và từ lặp.

    Tốt hơn SequenceMatcher khi thứ tự từ khác nhau:
    'nguyen trai quan 1' vs 'quan 1 nguyen trai' → 1.0
    """
    ta, tb = set(a.split()), set(b.split())
    if not ta or not tb:
        return 0.0
    giao = len(ta & tb)
    return giao / max(len(ta), len(tb))


def diem_ket_hop(a: str, b: str, trong_so: float = 0.6) -> float:
    """Kết hợp hai thước đo."""
    return trong_so * token_set_ratio(a, b) + (1 - trong_so) * do_tuong_dong(a, b)
Hai thước đo cho hai mục đích khác nhau:
| Thước đo | Mạnh ở | Yếu ở |
|---|---|---|
SequenceMatcher | Sai chính tả nhỏ, tên viết lệch ký tự | Thứ tự từ khác nhau |
token_set_ratio | Thứ tự từ khác, có từ thừa | Sai chính tả |
| Kết hợp | Cả hai trường hợp | — |
Bước 3 — Đối chiếu và cập nhật
import pandas as pd
from typing import NamedTuple


class KetQuaMatch(NamedTuple):
    ma_thiet_bi: str
    ma_co_so: str | None
    diem: float
    can_kiem_tra: bool
    lat: float | None
    lon: float | None


NGUONG_TU_DONG = 0.90      # >= ngưỡng này: tự động gán
NGUONG_NGHI_NGO = 0.75     # giữa hai ngưỡng: cần người kiểm tra


def doi_chieu(thiet_bi: pd.DataFrame, co_so: pd.DataFrame) -> pd.DataFrame:
    """Đối chiếu từng thiết bị với cơ sở phù hợp nhất."""
    # Chuẩn hoá một lần cho toàn bộ (không chuẩn hoá lại trong vòng lặp)
    thiet_bi = thiet_bi.copy()
    co_so = co_so.copy()
    thiet_bi["chuan_hoa"] = thiet_bi["dia_chi"].map(chuan_hoa)
    co_so["chuan_hoa"] = co_so["dia_chi"].map(chuan_hoa)

    ket_qua = []
    for _, tb in thiet_bi.iterrows():
        diem_tot_nhat, co_so_tot_nhat = 0.0, None

        for _, cs in co_so.iterrows():
            d = diem_ket_hop(tb["chuan_hoa"], cs["chuan_hoa"])
            if d > diem_tot_nhat:
                diem_tot_nhat, co_so_tot_nhat = d, cs

        if diem_tot_nhat >= NGUONG_TU_DONG:
            ket_qua.append(KetQuaMatch(
                tb["ma_thiet_bi"], co_so_tot_nhat["ma_co_so"], diem_tot_nhat,
                False, co_so_tot_nhat["lat"], co_so_tot_nhat["lon"],
            ))
        elif diem_tot_nhat >= NGUONG_NGHI_NGO:
            ket_qua.append(KetQuaMatch(
                tb["ma_thiet_bi"], co_so_tot_nhat["ma_co_so"], diem_tot_nhat,
                True, co_so_tot_nhat["lat"], co_so_tot_nhat["lon"],
            ))
        else:
            ket_qua.append(KetQuaMatch(tb["ma_thiet_bi"], None, diem_tot_nhat, True, None, None))

    return pd.DataFrame(ket_qua)
⚠️ Nguyên tắc quan trọng nhất trong bài toán này: không bao giờ tự động gán khi điểm nằm giữa hai ngưỡng. Việc đưa vào danh sách "cần người kiểm tra" tốn ít thời gian hơn rất nhiều so với việc sửa một tọa độ GPS sai đã bị ghi vào hệ thống. Thiết kế hệ thống phải thừa nhận giới hạn của thuật toán, không giả vờ nó luôn đúng.
Bước 4 — Geocoding: từ địa chỉ suy ra tọa độ
Khi đã match được cơ sở, tọa độ có thể đến từ ba nguồn:
| Nguồn | Độ chính xác | Chi phí | Ghi chú |
|---|---|---|---|
| Tọa độ có sẵn trong hệ thống | Cao nhất | 0 | Ưu tiên dùng |
| Geocoding API (Google, Mapbox) | Cao | Theo request | Cần API key, có giới hạn |
| Nominatim (OpenStreetMap) | Trung bình | Miễn phí | Giới hạn 1 request/giây, phải có User-Agent |
import time
import requests


def geocode_nominatim(dia_chi: str, cache: dict) -> tuple[float, float] | None:
    """Tra tọa độ qua Nominatim. BẮT BUỘC: tôn trọng rate limit."""
    khoa = chuan_hoa(dia_chi)
    if khoa in cache:
        return cache[khoa]

    try:
        r = requests.get(
            "https://nominatim.openstreetmap.org/search",
            params={"q": dia_chi, "format": "json", "limit": 1, "countrycodes": "vn"},
            headers={"User-Agent": "NoiBo-PCCC-Matching/1.0 (lien-he@congty.vn)"},
            timeout=10,
        )
        r.raise_for_status()
        du_lieu = r.json()

        if not du_lieu:
            cache[khoa] = None
            return None

        ket_qua = (float(du_lieu[0]["lat"]), float(du_lieu[0]["lon"]))
        cache[khoa] = ket_qua
        return ket_qua

    except (requests.RequestException, ValueError, KeyError, IndexError):
        cache[khoa] = None
        return None
    finally:
        time.sleep(1.1)      # TÔN TRỌNG rate limit 1 req/s
⚠️ Nominatim là dịch vụ miễn phí do cộng đồng OpenStreetMap tài trợ. Vi phạm giới hạn 1 request/giây có thể khiến IP của bạn bị chặn. Ngoài ra, dùng khối lượng lớn cho mục đích thương mại vi phạm điều khoản sử dụng — hãy dùng Google/Mapbox có trả phí trong trường hợp đó.
Kiểm tra kết quả — bước cuối không được bỏ qua
def kiem_tra_toa_do(lat: float, lon: float) -> bool:
    """Kiểm tra tọa độ có nằm trong lãnh thổ Việt Nam không."""
    return bool(lat and lon and 8.0 <= lat <= 23.5 and 102.0 <= lon <= 110.0)


def bao_cao_chat_luong(kq: pd.DataFrame) -> None:
    tong = len(kq)
    tu_dong = (~kq["can_kiem_tra"]).sum()
    co_toa_do = kq["lat"].notna().sum()

    print(f"Tổng thiết bị:        {tong}")
    print(f"Tự động gán được:     {tu_dong} ({tu_dong / tong:.1%})")
    print(f"Cần kiểm tra tay:     {tong - tu_dong} ({(tong - tu_dong) / tong:.1%})")
    print(f"Có tọa độ hợp lệ:     {co_toa_do} ({co_toa_do / tong:.1%})")
    print(f"Điểm trung bình:      {kq['diem'].mean():.3f}")
    print(f"  - Trên 0.90:        {(kq['diem'] >= 0.90).sum()}")
    print(f"  - 0.75 đến 0.90:    {((kq['diem'] >= 0.75) & (kq['diem'] < 0.90)).sum()}")
    print(f"  - Dưới 0.75:        {(kq['diem'] < 0.75).sum()}")
Điều cần kỳ vọng: với dữ liệu thực tế chưa được làm sạch, tỷ lệ tự động gán đúng thường chỉ đạt 60–80%. Con số 20–40% còn lại cần người kiểm tra. Đây là kết quả bình thường — đừng cố ép thuật toán đạt 100% bằng cách hạ ngưỡng, vì bạn sẽ đưa dữ liệu sai vào hệ thống.
Năm sai lầm phổ biến
- Hạ ngưỡng để đạt tỷ lệ tự động cao — đổi lấy dữ liệu sai trong hệ thống.
- Không chuẩn hoá Unicode — lỗi so khớp khó hiểu giữa các máy khác hệ điều hành.
- Không cache kết quả geocoding — chạy lại tốn thời gian và có thể vượt rate limit.
- Dùng thuật toán O(n×m) với dữ liệu lớn — 702 × 221 = 155.000 phép so sánh, chấp nhận được; nhưng 100.000 × 50.000 là bất khả thi.
- Không kiểm tra tọa độ sau khi lấy — geocoding có thể trả về địa điểm cùng tên ở tỉnh khác.
💡 Khi dữ liệu lớn hơn nhiều, hãy dùng blocking: chia dữ liệu thành nhóm theo tiêu chí chắc chắn (quận/huyện, mã bưu chính) rồi chỉ so sánh trong từng nhóm. Điều này giảm số phép so sánh từ O(n×m) xuống gần O(n+m). Với 100.000 bản ghi, đây là khác biệt giữa vài giây và vài giờ.